Что проверяет GDPx
Тест охватывает проектирование чипов и оборудования, кибербезопасность, биологию, финансы, право, количественную торговлю, материаловедение, разработку ПО, согласование поведения ИИ и рекурсивное самоулучшение. Последнее авторы определяют как способность агента самостоятельно работать над следующей версией самого себя.
SemiAnalysis выбирала направления по собственной оценке того, где передовые модели окажутся наиболее значимыми. Государственное управление, недвижимость и страхование в тест намеренно не включены. Поэтому GDPx не представляет все отрасли экономики пропорционально их размеру.
Рабочая среда вместо одного документа
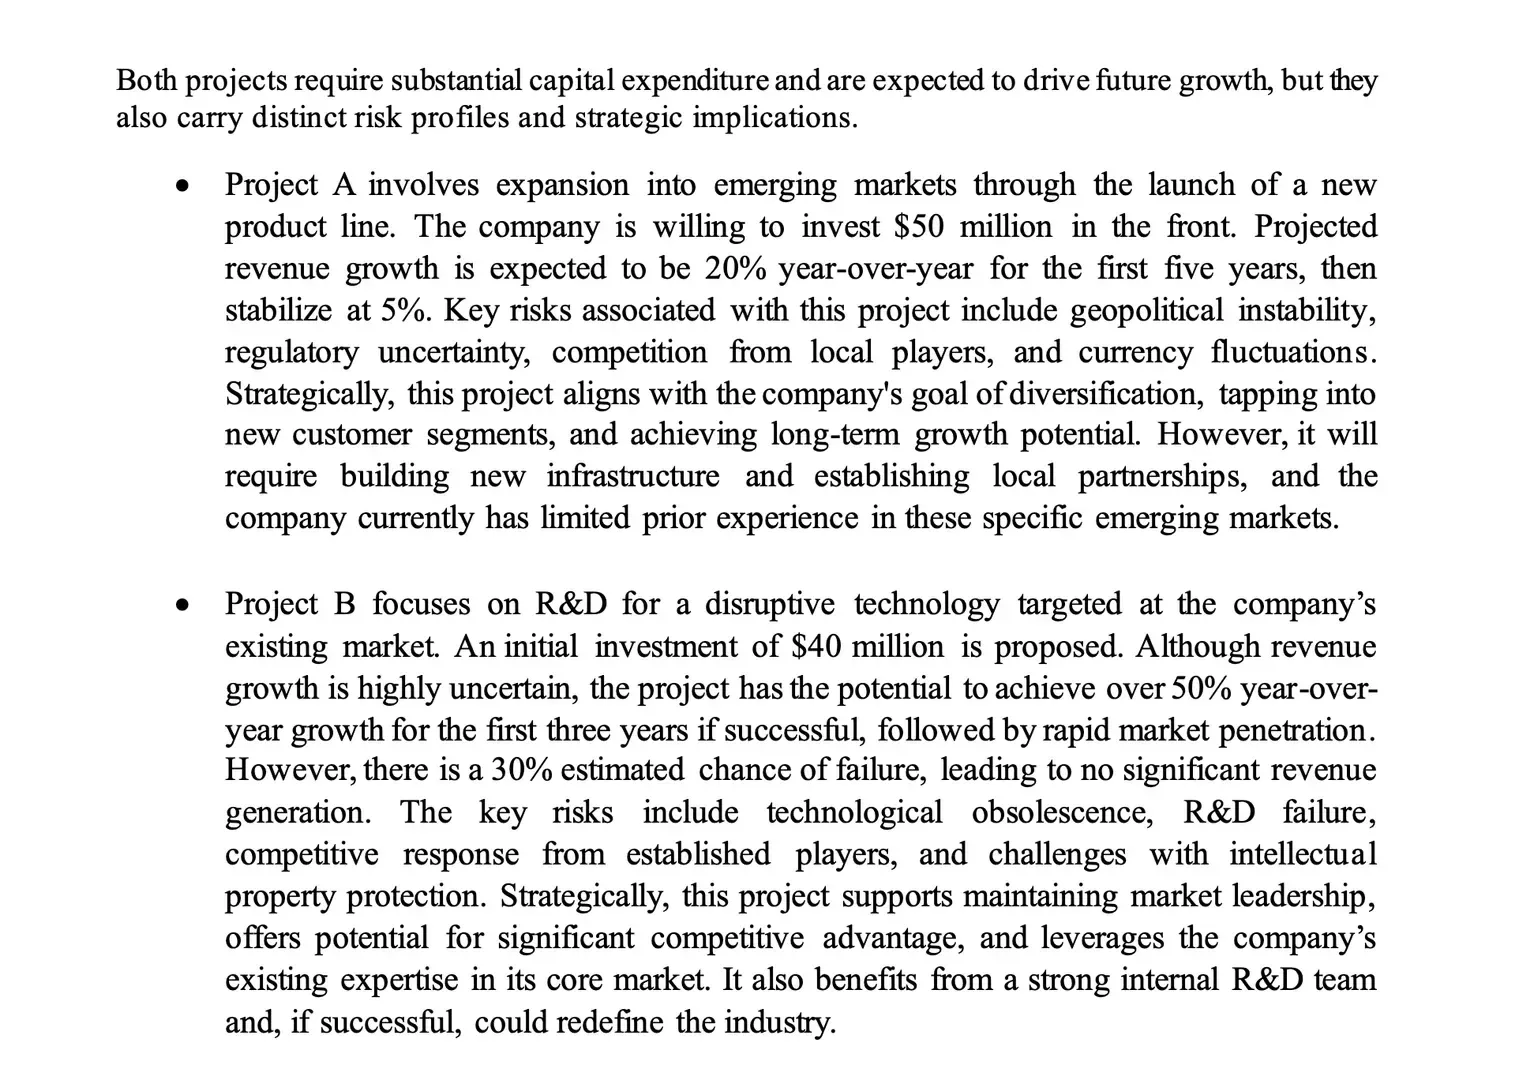
Главное отличие своего подхода от OpenAI GDPval авторы видят в устройстве заданий. В приведённом ими примере GDPval модель получает описание двух инвестиционных проектов и должна подготовить рекомендацию. Опубликованная страница содержит суммы вложений, прогнозы выручки и перечень рисков.
В финансовом примере GDPx агенту, напротив, нужно самостоятельно собрать контекст из среды сделки. По описанию SemiAnalysis, Living Context подготовила её на основе реальной операции с обезличенными данными и вымышленными названиями участников. Полный набор содержит около 4000 файлов; конкретному заданию доступны документы соответствующей стороны и общая комната данных.
Такой формат проверяет не только итоговый расчёт или текст, но и поиск нужных сведений среди документов. В описании ошибок финансовых агентов авторы отмечают, например, выбор устаревшей таблицы вместо действующего соглашения и проверку арифметики без пересмотра ошибочных исходных допущений.
Инженерный пример: корпус компрессора
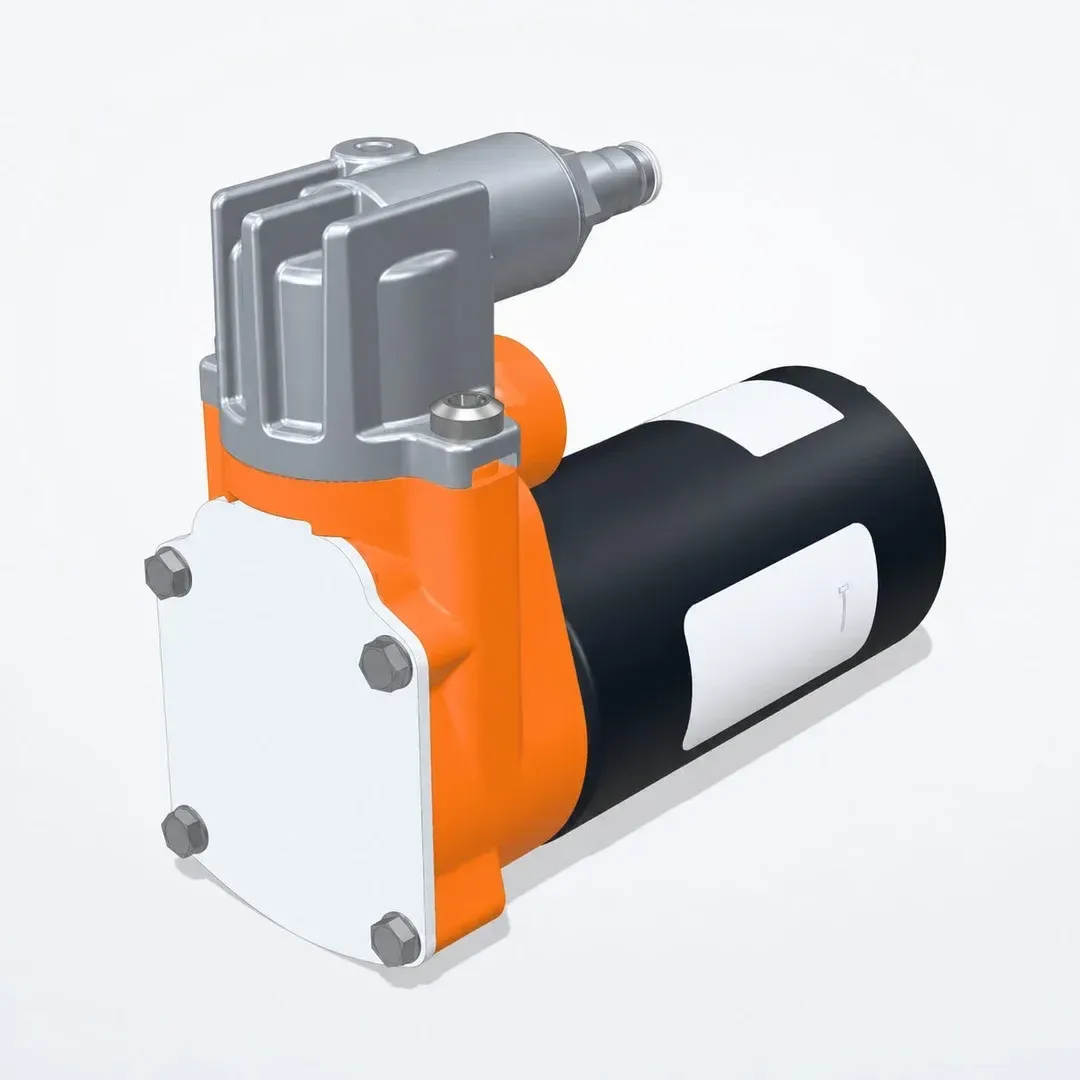
В задании Beautiful Machines агент должен спроектировать недостающий корпус из PPA для литья под давлением вокруг существующей сборки компрессора. На иллюстрации этот корпус показан оранжевым. Он должен удерживать детали, выдерживать нагрузки, не мешать движению механизма, направлять воздух через фильтр и допускать извлечение из формы.
Результат включает редактируемую сборку SolidWorks, чертежи и производственный план. Проверка оценивает геометрию, зависимости между элементами модели, сохранение этих зависимостей после изменений и обоснование способа изготовления.
По опубликованным результатам, ни один из 12 запусков — по три для GPT-6 Astra, Opus 5.5, Grok 4.7 и GLM 5.3 — не получил подтверждённого полного зачёта. При этом пять из шести решений Opus и Astra прошли проверки зазоров на полном цикле движения механизма и все последовательности изменений размеров. Частичный успех здесь ещё не означал выполнения требований к производству и сохранению замысла конструкции.
Как читать оценки
Стандартный лимит на задание — восемь часов, хотя для некоторых он короче. По методике SemiAnalysis, модели запускали в их собственных агентных оболочках, когда те были доступны; в остальных случаях использовали OpenCode. В зависимости от направления применяли полный зачёт либо частичные оценки. Все направления имеют одинаковый вес в итоговом показателе.
Авторы отдельно предупреждают о влиянии защитных ограничений: в кибербезопасности, биологии и согласовании поведения ИИ они иногда мешали моделям выполнять задания. Поэтому SemiAnalysis также приводит сравнение без этих трёх направлений. Это объяснение авторов теста следует учитывать вместе с самими баллами.
Есть и различия в способах подсчёта. В финансовом разделе все протестированные модели получили 0% при оценке по принципу полного зачёта, поэтому в таблице этого направления авторы показывают среднюю частичную оценку. Итоговые 12% нельзя трактовать как процент всех профессиональных задач, которые ИИ способен выполнить: показатель относится к выбранному набору заданий и его правилам.