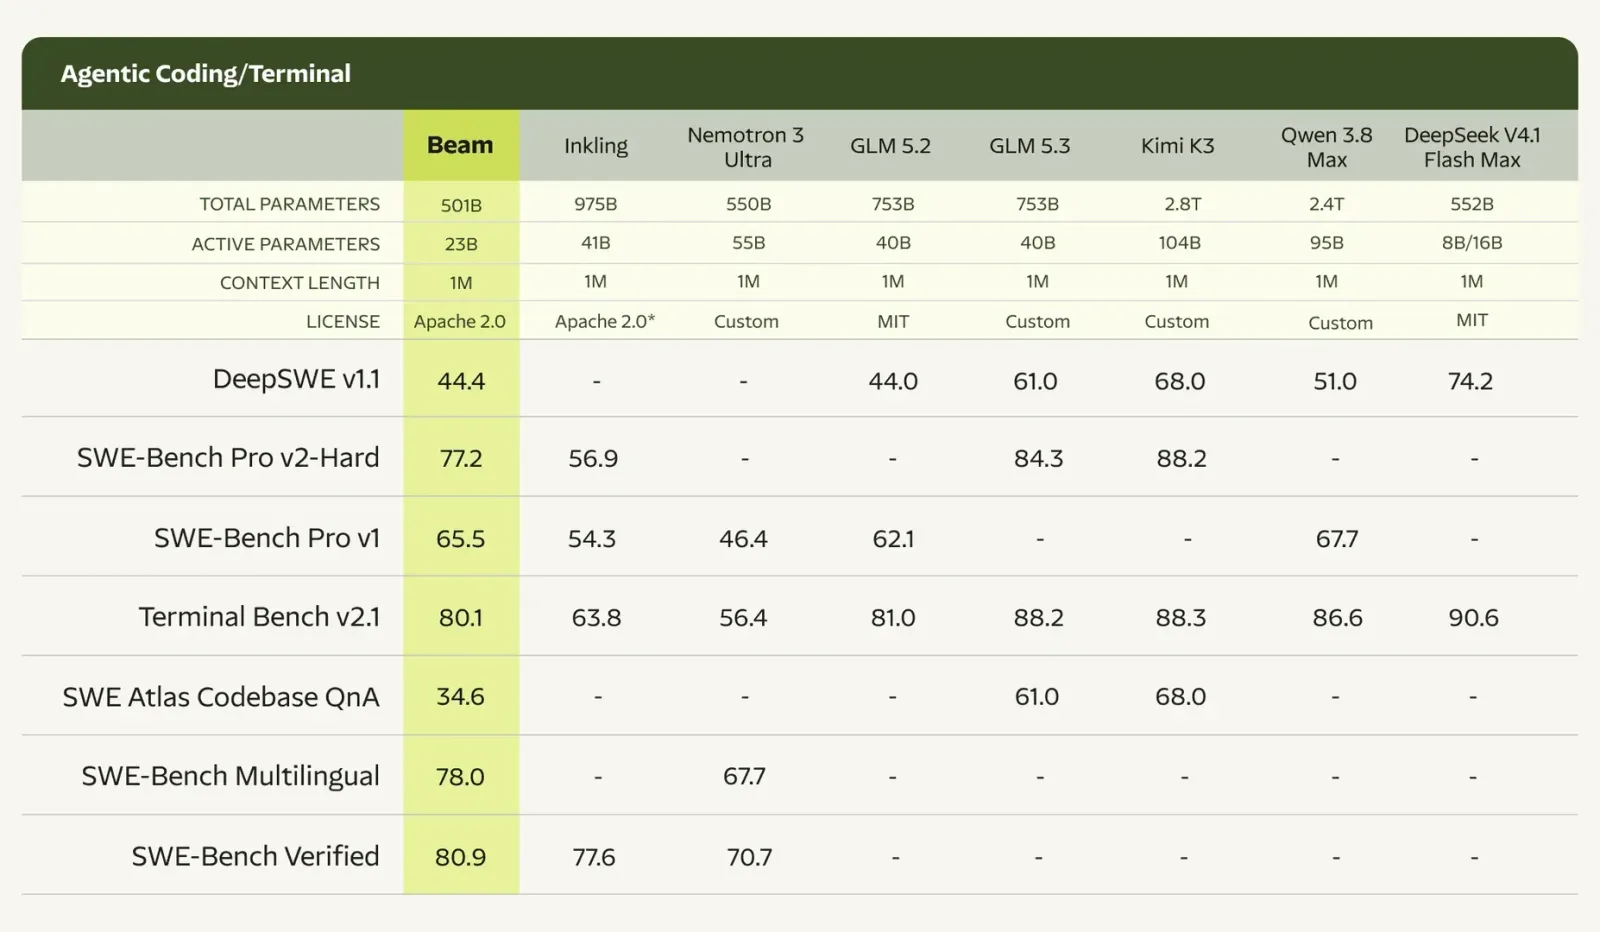
Reflection представила Beam — свою первую открытую языковую модель. В ней 501 млрд параметров, однако при обработке каждого токена активны 23 млрд: модель использует архитектуру mixture-of-experts.
Для чего предназначена Beam
Компания позиционирует модель для программирования, рассуждений и агентных сценариев. Документация Hugging Face описывает текстовый ввод и вывод, контекст до миллиона токенов, настройку объёма рассуждений и работу с вызовами инструментов.
В 52 слоях модели первые три используют плотные MLP, а в остальных токен направляется к 8 из 256 экспертов. Такой подход сокращает вычисления на токен относительно плотной модели того же общего масштаба, но не отменяет требования хранить все веса в памяти.
Главное ограничение — инфраструктура
Открытость весов не делает Beam локальной моделью для обычного компьютера. В документации размер BF16-чекпойнта указан примерно в 1 ТБ, а рекомендуемый пример запуска распределяет экспертов по нескольким GPU. Поэтому модель ориентирована на организации с серверными ускорителями или облачными ресурсами.
Как её обучали
Reflection сообщает о предварительном обучении на 23,8 трлн токенов и последующем обучении с подкреплением: свыше 100 млн rollout-эпизодов на 10,5 тыс. NVIDIA GB300 за четыре недели. Компания также приводит сравнения с другими моделями по качеству и вычислительной эффективности.
Эти показатели опубликованы самой Reflection; независимого подтверждения сравнительных результатов в использованных материалах нет. Для разработчиков практический смысл Beam сейчас в возможности самостоятельно изучить и адаптировать большую открытую модель, если доступна подходящая инфраструктура.