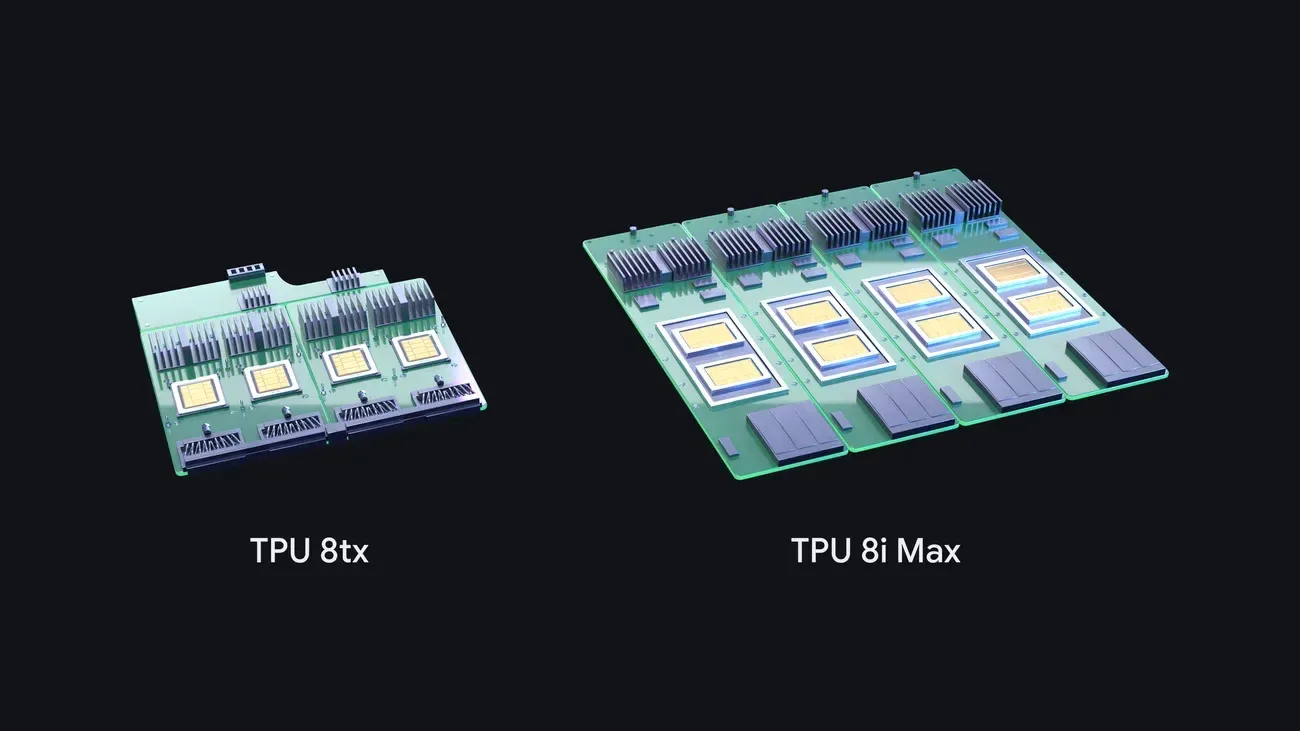
TPU 8tx рассчитана на инференс — выполнение уже обученных моделей, — а также на небольшие задачи обучения. Google адресует систему компаниям из регулируемых отраслей и государственным организациям, которым нужно запускать собственные модели и ИИ-агентов рядом с закрытыми данными.
Что изменилось в TPU 8tx
В основе TPU 8tx лежит тот же кремний, что и в TPU 8t, но система получила другую конфигурацию сетевого соединения и защиты. Вместе с ускорителями работают серверные процессоры AMD EPYC пятого поколения. Google подчёркивает, что речь идёт о новой системе вокруг существующего чипа: изменения затрагивают сочетание вычислений, памяти, сети и механизмов безопасности.
Главное отличие — защита информации во время обработки. Шифрование при хранении и передаче само по себе не закрывает этот этап: для вычислений данные обычно раскрываются в памяти. По описанию Google, TPU 8tx обеспечивает аппаратную защиту и изоляцию чувствительных данных и весов моделей, пока они используются.
Для обмена данными TPU 8tx использует сеть Boardfly с низкими задержками. Google заявляет о снижении задержки до двух раз относительно TPU 8t. Это сравнение производителя, а не результат независимого тестирования.
Запуск и настройка моделей в одной системе
Сочетание вычислительных возможностей для обучения и сети для инференса позволяет выполнять несколько этапов работы с моделью на одной системе. В числе сценариев Google называет дообучение на частных данных, дистилляцию больших моделей в меньшие и обучение агентов с подкреплением.
Практический смысл такого подхода — возможность запускать и настраивать модели без переноса чувствительных данных между отдельными кластерами. Заявленные свойства защиты при этом не следует воспринимать как безусловную гарантию безопасности любой конфигурации или приложения.
Чем отличается TPU 8i Max
Одновременно Google представила TPU 8i Max для задач с большими контекстными окнами. В одном корпусе объединены два чипа TPU 8i. По данным компании, относительно TPU 8i удвоены вычислительные ресурсы, объём SRAM и пропускная способность памяти HBM.
У двух новинок разные приоритеты: TPU 8tx предназначена для конфиденциальных вычислений, а TPU 8i Max — для обработки большого контекста и увеличения плотности вычислений в стойке. Они дополняют TPU 8t для масштабного обучения и TPU 8i для рассуждающих моделей с низкой задержкой.
Условия доступности
Google не указала в анонсе сроки общей доступности TPU 8tx, список регионов и цены. Поэтому оценить стоимость перехода и спланировать развёртывание по этому сообщению пока нельзя.